Bez „i”, „w”, „na”, „się”, „że” trudno ułożyć zdanie po polsku. Same w sobie nie niosą jednak znaczenia i dlatego większość programów do analizy tekstów przez lata je pomijała, traktując jako tzw. stopwords. Czy dalej się tak robi i jakie problemy to za sobą ciągnie? Jak podejść do tych słów przy optymalizacji pod algorytmy wyszukiwarek?
Co to są stopwords?
Stopwords to najczęściej występujące słowa w danym języku, które same w sobie, bez kontekstu reszty zdania, nie mają większego znaczenia – dlatego przy przetwarzaniu tekstu się je odfiltrowuje. W języku angielskim będą to m.in. the, a, of czy to. Na polskiej liście znajdziemy z kolei głównie przyimki (w, na, z, do), spójniki (i, oraz, ale), partykuły i zaimki (nie, się, to). Rodzajników, jak angielskie the czy a, w polszczyźnie oczywiście nie mamy.
Co jeszcze jest ważne, nie istnieje żadna uniwersalna lista stopwords; każde narzędzie korzysta z własnej. Dla przykładu, w bazie danych MySQL domyślna lista silnika InnoDB liczy 36 słów, a starszego MyISAM… aż 543.
Po co usuwa się stopwords?
Powody są w zasadzie dwa:
- stopwords pojawiają się niemal w każdym zdaniu, więc pomijając je, możemy „odchudzić” bazę danych albo indeks treści do analizy;
- słowa, które występują w każdym dokumencie, w niczym nie pomagają odróżnić ich od siebie. Jeśli szukamy w jakimś zbiorze tekstów, powiedzmy, przepisu na sernik, liczą się „przepis” i „sernik”, a nie „na”.
Obecnie stopwords odfiltrowuje się głównie w wyszukiwarkach wewnętrznych, bazach danych i przy przetwarzaniu języka naturalnego (NLP).
Haczyk polega na tym, że czasem to właśnie te „nieistotne” słowa decydują o sensie frazy. Weźmy nazwę legendarnej grupy The Who – oba słowa są na domyślnej liście InnoDB, więc po ich odfiltrowaniu z frazy nie zostałoby… nic. Z podobnym problemem (tylko że jeszcze szerszym) przez lata mierzyły się też wyszukiwarki internetowe.
Czy Google pomija stopwords?
Do 2019 roku silnik Google również w większości ignorował stopwords, głównie po to, by zaoszczędzić miejsce i czas przy indeksowaniu. Były to zresztą czasy, kiedy algorytm traktował zapytania użytkowników raczej jako ciągi fraz kluczowych niż całe spójne zdania.
Przełom przyszedł w momencie, gdy Google zaprezentowało (oraz wprowadziło do algorytmu wyszukiwarki) BERT-a – model językowy, który potrafi analizować znaczenie słów patrząc na cały ich kontekst, czyli na wyrazy znajdujące się przed, jak i po danym słowie. Wobec tego ignorowanie stopwords nie miało już sensu, bo te potrafią zmienić cały kontekst zdania. Pandu Nayak – obecnie wiceprezydent działu Search w Google – wyjaśnił to tak: przed wprowadzeniem BERT-a, gdy algorytm otrzymał zapytanie „2019 brazil traveler to usa need a visa”, pomijał słowo „to”, przez co zwracał wyniki dla… Amerykanów lecących do Brazylii. BERT tego błędu nie popełnia i uwzględnia „to” jako kontekst, dzięki czemu rozumie, że chodzi o podróż w drugą stronę.
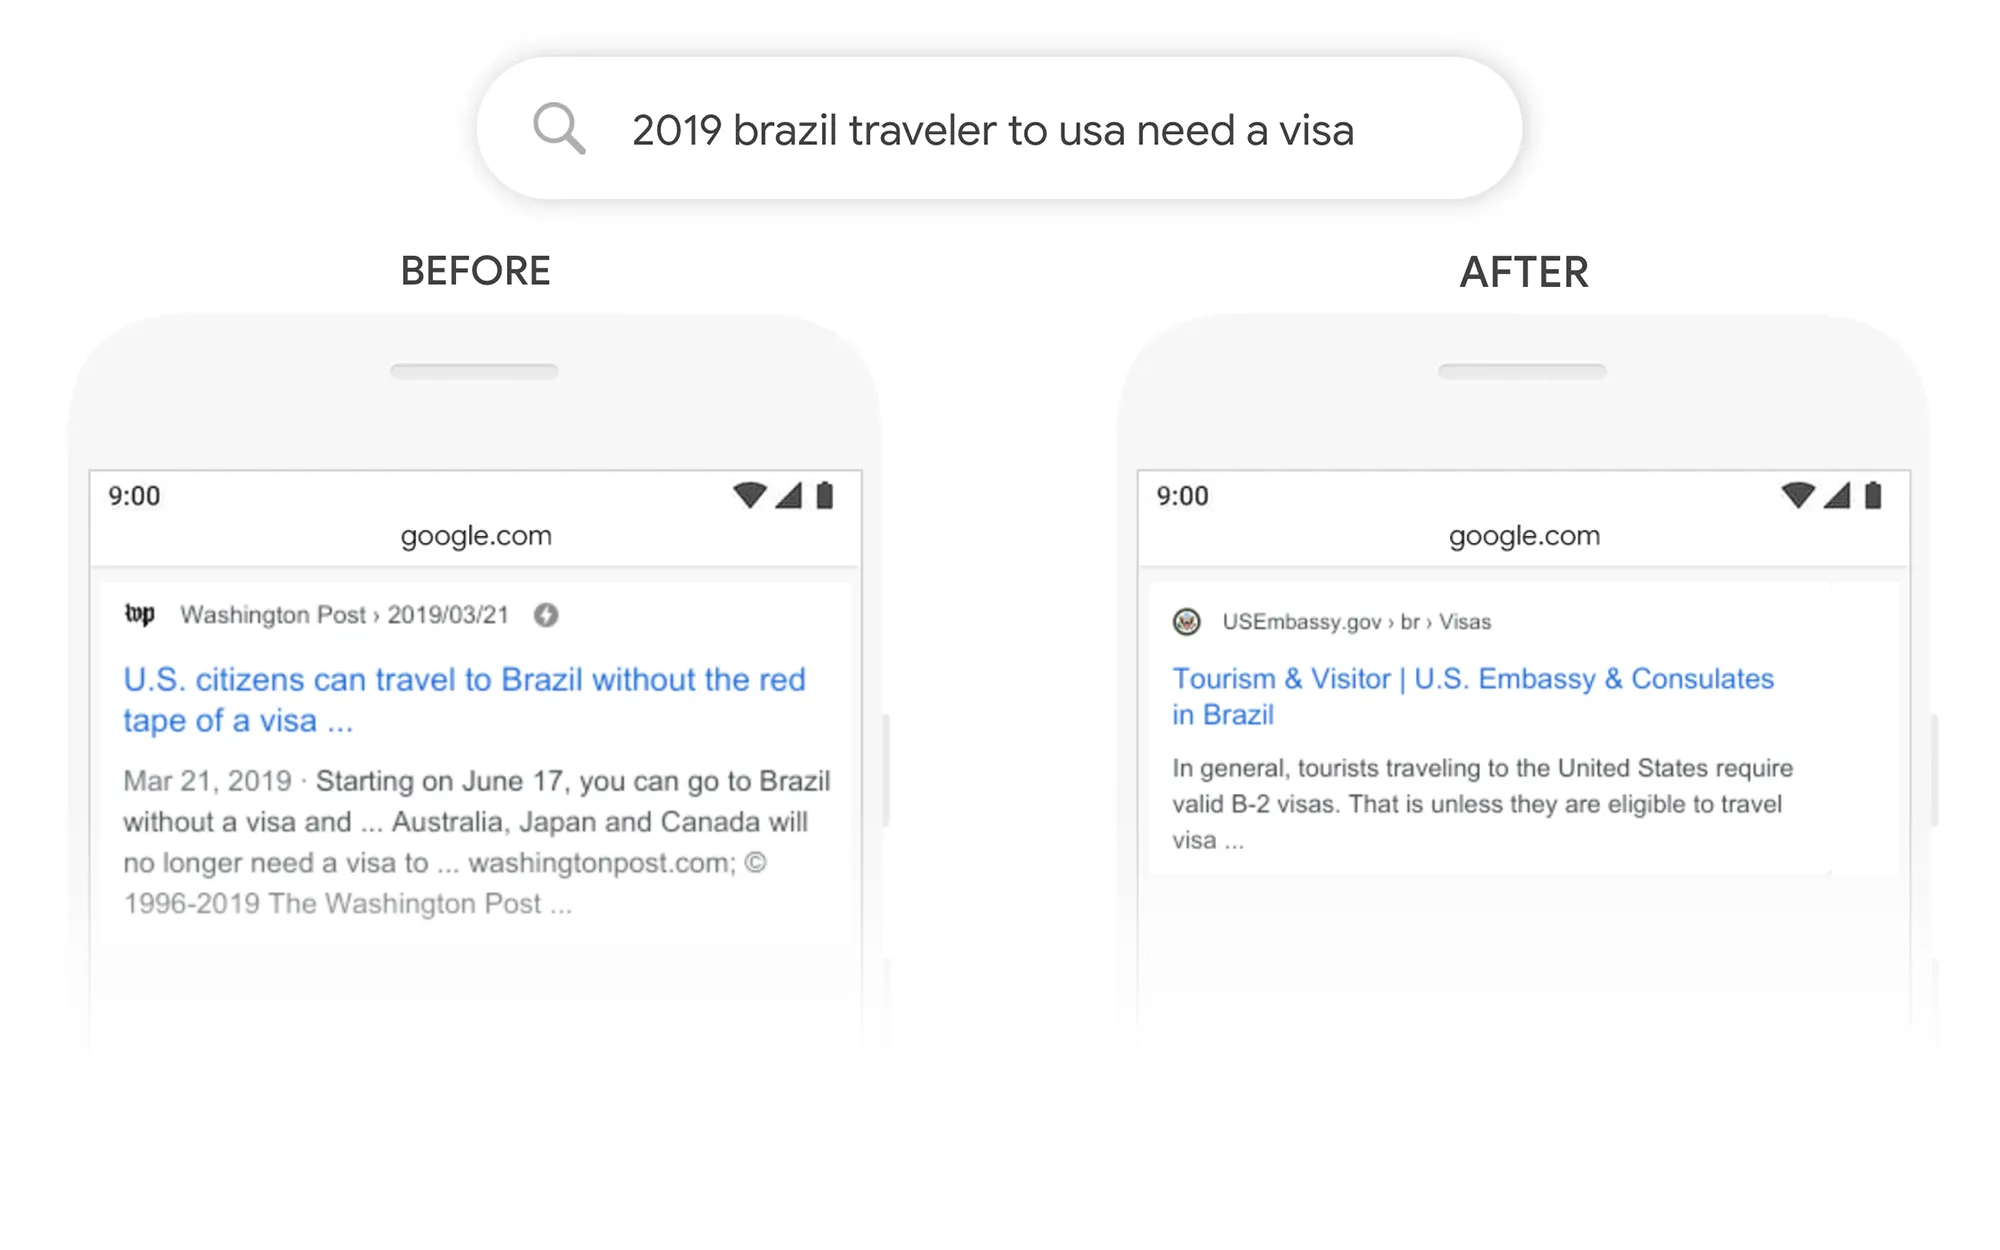
Zdj 1. Wiadomo, że jedno słowo potrafi zmienić znaczenie całej wypowiedzi – teraz wiedzą to też algorytmy Google.
Źródło: blog.google/products-and-platforms/products/search/search-language-understanding-bert
W 2021 roku na Twitterze odniósł się do tego również John Mueller, znany chyba wszystkim specjalistom SEO ekspert Google. Na pytanie, czy stopwords mają jakikolwiek wpływ na pozycjonowanie, odpowiedział krótko: „I wouldn’t worry about stop words at all; write naturally” – czyli nie przejmuj się nimi, pisz naturalnie.
Stopwords w SEO – kiedy mogą mieć znaczenie?
Konsensus w świecie SEO wygląda więc tak, że – zgodnie z tym, co mówi Mueller i inni eksperci Google – nie należy się martwić o stopwords przy optymalizacji treści, tytułów, nagłówków czy meta danych. Tak naprawdę jedynym obszarem, w którym zwraca się czasem na to uwagę, są adresy URL. Krótszy slug z zasady jest bardziej czytelny, więc jeśli da się z niego wyciąć „zbędne” słowa bez utraty jego znaczenia, warto to zrobić. Nie ma to, co prawda, większego znaczenia dla algorytmów, ale może sprawić, że URL będzie nieco bardziej przyjazny.
Nawet i tu trzeba jednak uważać. Jeżeli, przykładowo, mamy adres ze slugiem „/jak-wybrac-ekspres-do-kawy”, nie moglibyśmy skrócić go do „/wybrac-ekspres-kawy” – ten drugi może jest krótszy, ale czyta się go topornie.
Najważniejsze, by – jak podkreśla Mueller – tekst brzmiał naturalnie… a to byłoby niemożliwe bez wszystkich „i”, „w”, „na” czy „się”.
swój potencjał z
polityką prywatności